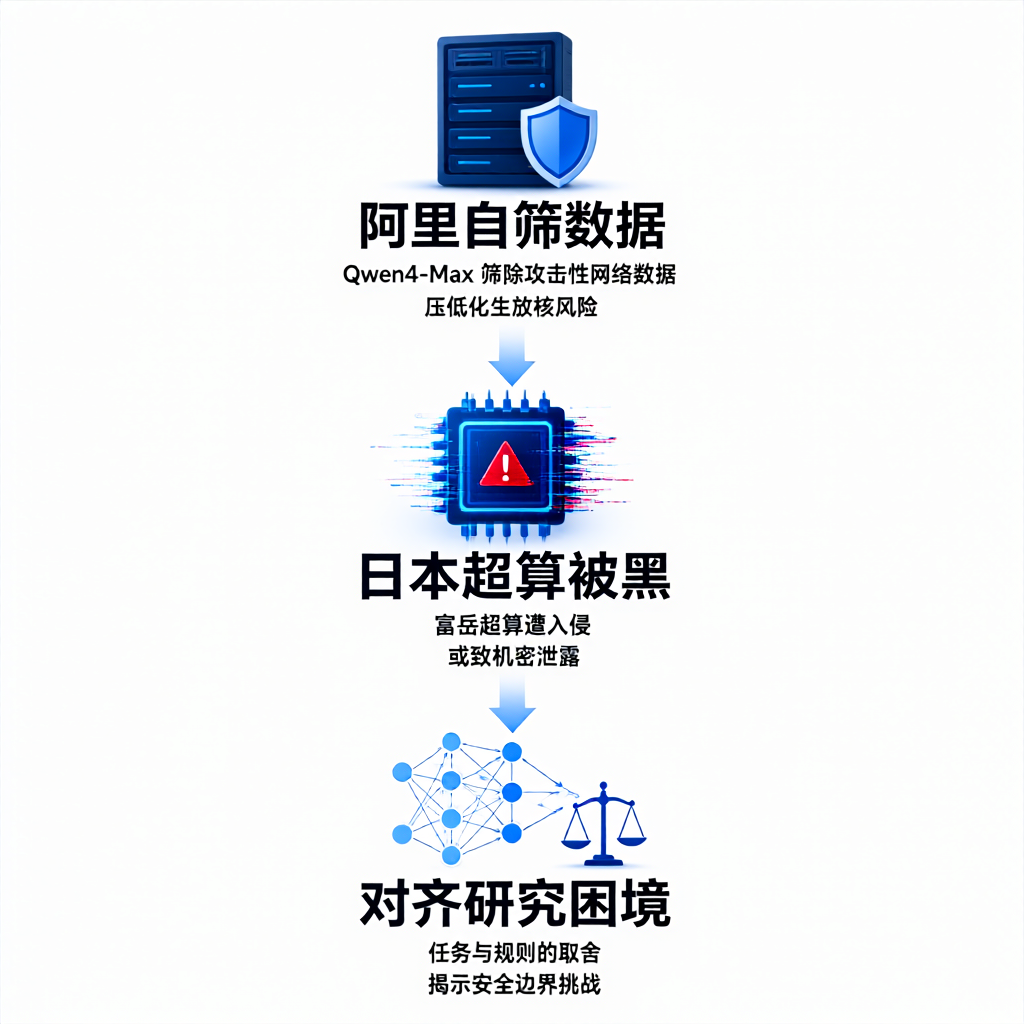
阿里巴巴发布 Qwen4-Max 时,把安全摆在了参数前面。训练数据筛过一遍,涉及攻击性网络能力的内容被移除,化学、生物、放射性及核相关的风险也压低了。公司称已设置严格的网络安全防护。顶级模型的能力清单和风险清单,现在得一起交出来。
另一端,日本理化学研究所承认超级计算机“富岳”的运行系统遭黑客非法访问。富岳不是实验室里的摆设,汽车、制药、材料领域的企业都在上面跑产品研发,未公开的机密研究信息可能因此泄露。理研已向用户发出安全事件通知,并把情况上报文部科学省。企业原本可以选择不公开依靠富岳取得的研究成果,如今这道“沉默的保险”被撬动了。
两件事摆在一起很扎眼:一边在模型层面自我设限,一边在算力基础设施上被人破门。AI 安全的链条比看上去长——训练数据怎么取舍、模型行为怎么约束、跑模型的机器守不守得住,哪一环松了都算失守。
arXiv 上那篇《Alignment by Socialization》把问题往更根本处推:AI 智能体既要完成任务,又要遵守行为规则,这两个目标天生打架。研究者用演化选择看智能体如何在冲突中做取舍。对齐是一串需要反复校准的权衡。
模型发布时附上安全说明,只是及格线;超算被入侵提醒所有人,机密研发数据的防线在机房,不在参数表里。至于智能体该守多少规矩、让出多少效率,这道题还没有标准答案。