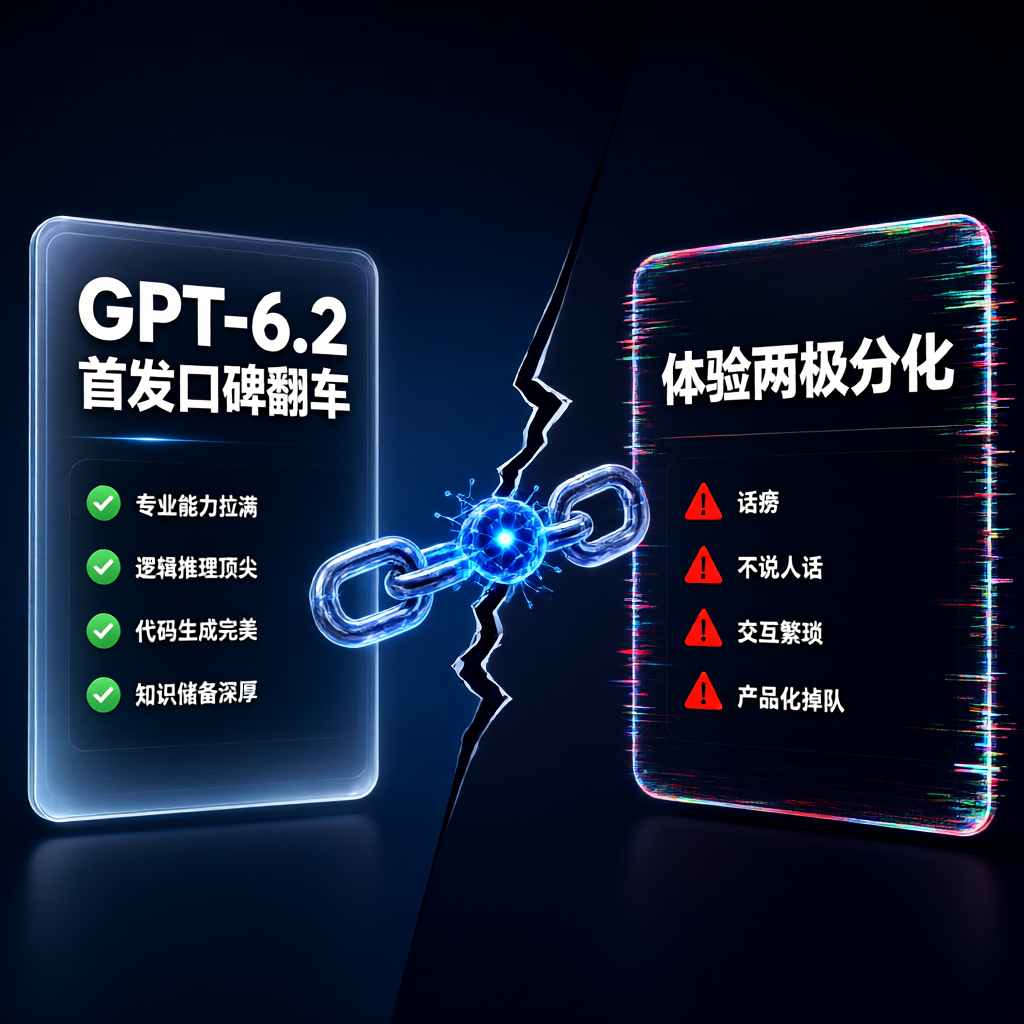
拖更两个月,GPT-6.2(Astra)终于上线。宣传拉满,结果首发24小时口碑直接翻车,硅谷大佬集体打差评。期待值越高,摔得越响。
硬实力确实没得黑。数学、代码、专业工作场景一条龙,能力上限比上一代明显高一截,官方主打的也就是“继续卷专业工作能力”。但它有个毛病——话痨。活干完了非要再写一份长篇汇报,把每一步思路摊开给你看,“汇报狂魔”这外号不冤。
问题出在嘴上。实测里用户吐槽最多的不是算错,而是它不说人话。一句话能讲清的事非要绕三段,提问稍微含糊一点,它就自顾自地开始表演推理。“只会做数学题,不会说人话”——这句评价挺毒,但准。
所以体验才会严重两极分化:跑分党觉得强得离谱,日常用户觉得难用得要死。能力是模型的事,好用是产品的事,这次明显是后者拖了后腿。
结论不复杂。GPT-6.2证明了专业能力还有得卷,也证明了卷完能力不等于好用。模型再强,说不清人话,用户照样跑。