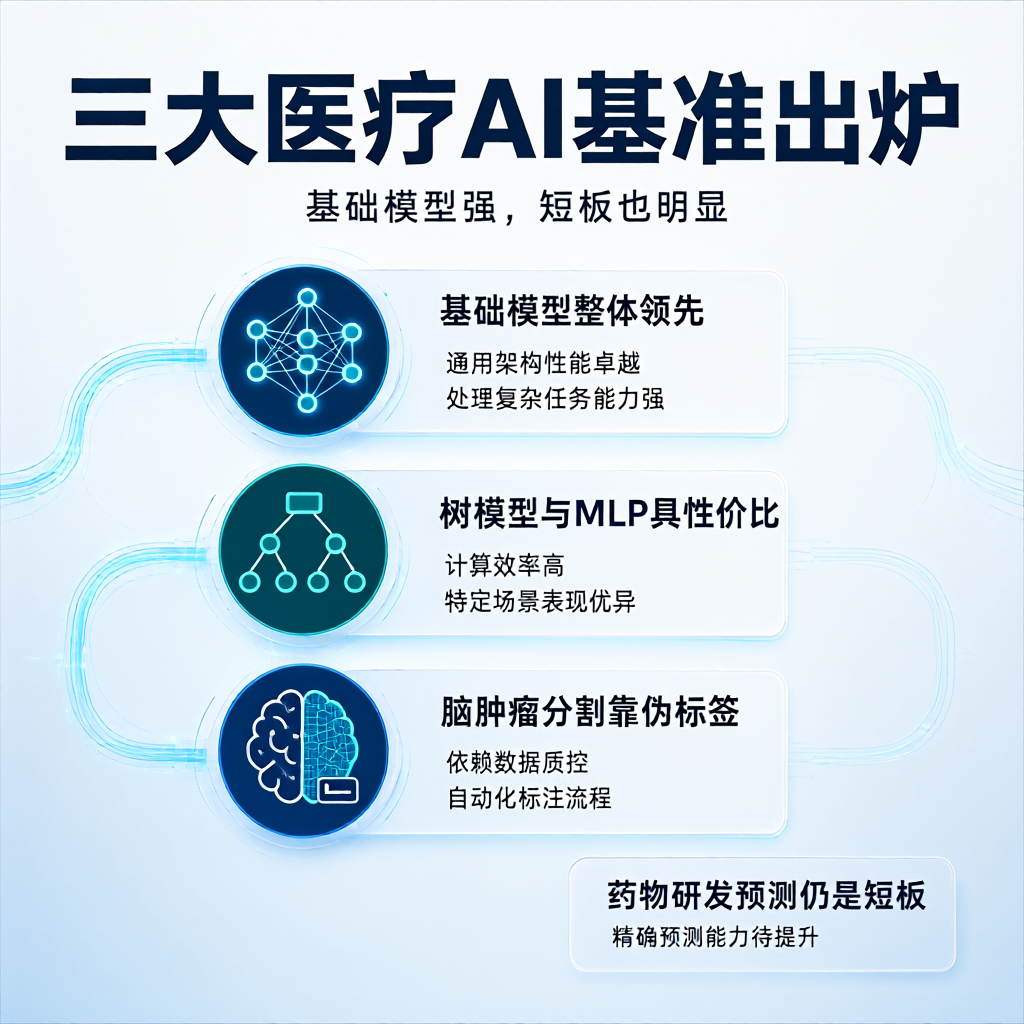
医疗AI的基准测试最近扎堆往外冒,一口气铺到三条线上:表格数据、脑肿瘤分割、药物研发。结论先摆在这儿:基础模型确实领先,但没到碾压的程度,短板还都卡在最要命的地方。
TabBioMed收了94个公开生物医学数据集,电子健康记录、药物发现、基因组、转录组、蛋白质组全在里面,还配了一套统一的预处理和评估框架,分类、回归、多任务都能复现对比。团队跑了23种模型,经典方法、梯度提升树、表格神经网络、表格基础模型都在其中。整体看,基础模型这一族预测性能最强。可这份优势要看数据条件,推理或训练成本一紧,基于树的模型和调好的多层感知机照样能打。数据集、划分、代码和基线结果都已上GitHub。
影像这边,BraTS-GoAT 2026 Task 3做的是异质实体下的脑肿瘤分割,共享ET、TC、WT三个区域。参赛方案用3D ResidualEncoderUNet,训练靠两样东西撑起来:经过质量控制的共识伪标签,加上密集的专家标注。标注贵、专家少,伪标签配质控基本成了现实解法。
OpenAI的MedChemBench盯着药物研发:99道题、761个分子结构,从结构组装一路测到性质预测。GPT-6.2 Astra以84.5%的可用分领跑,但化合物筛选和数值预测仍是明显弱项。这两块恰恰是药企最花钱的环节。
三个基准指向同一件事:医疗AI的比拼已经从「能不能做」变成「哪块做不好」。榜单分高不等于能进诊室或实验室,尤其在需要精确数值的地方,差距还很实在。