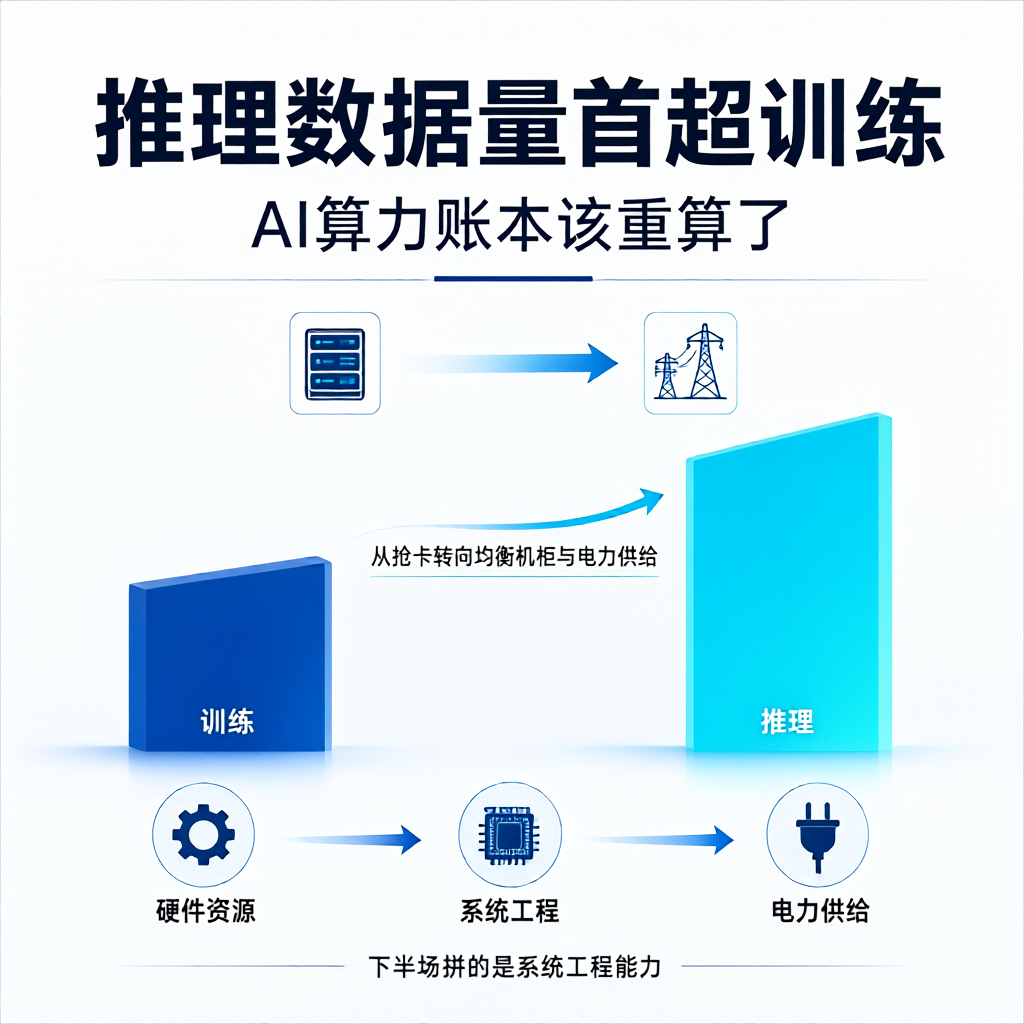
赛迪研究院最新报告给出一个明确信号:我国人工智能推理数据量首次超过训练数据量,截至6月日均词元调用量突破175万亿。这个数字的意义不在大小,在于方向——AI从模型训练的"炼丹"阶段,正式走进规模化产业应用。训练是一次性的巨额投入,推理是每天都要付的账单。算力的需求结构,变了。
推理负载跟训练完全不是一回事。Agent兴起后,一次任务要反复调模型、反复取数据,多轮往返成了常态。这类活儿讲究并发、延迟和单位成本,不看单卡跑分。于是CPU从配角回到台前,负责调度、预处理和逻辑编排。企业买算力的逻辑跟着变:不再只盯着加速卡,而是配一整套均衡的算力机柜,让不同芯片各干各的活。
机柜配齐了,电从哪来?这才是硬约束。一张高端加速卡的功耗顶好几台服务器,一个万卡集群的用电量够一个中等县城。电网容量、散热方案、交付周期,任何一个环节卡住,算力都落不了地。算力的尽头是电力,这话不是危言耸听。
所以AI竞争的下半场,比的不再是谁抢到更多卡,而是一整套系统工程:能不能拿到电、能不能造出机柜、能不能把推理成本压下来。芯片只是入场券,电力与制造能力才是天花板。