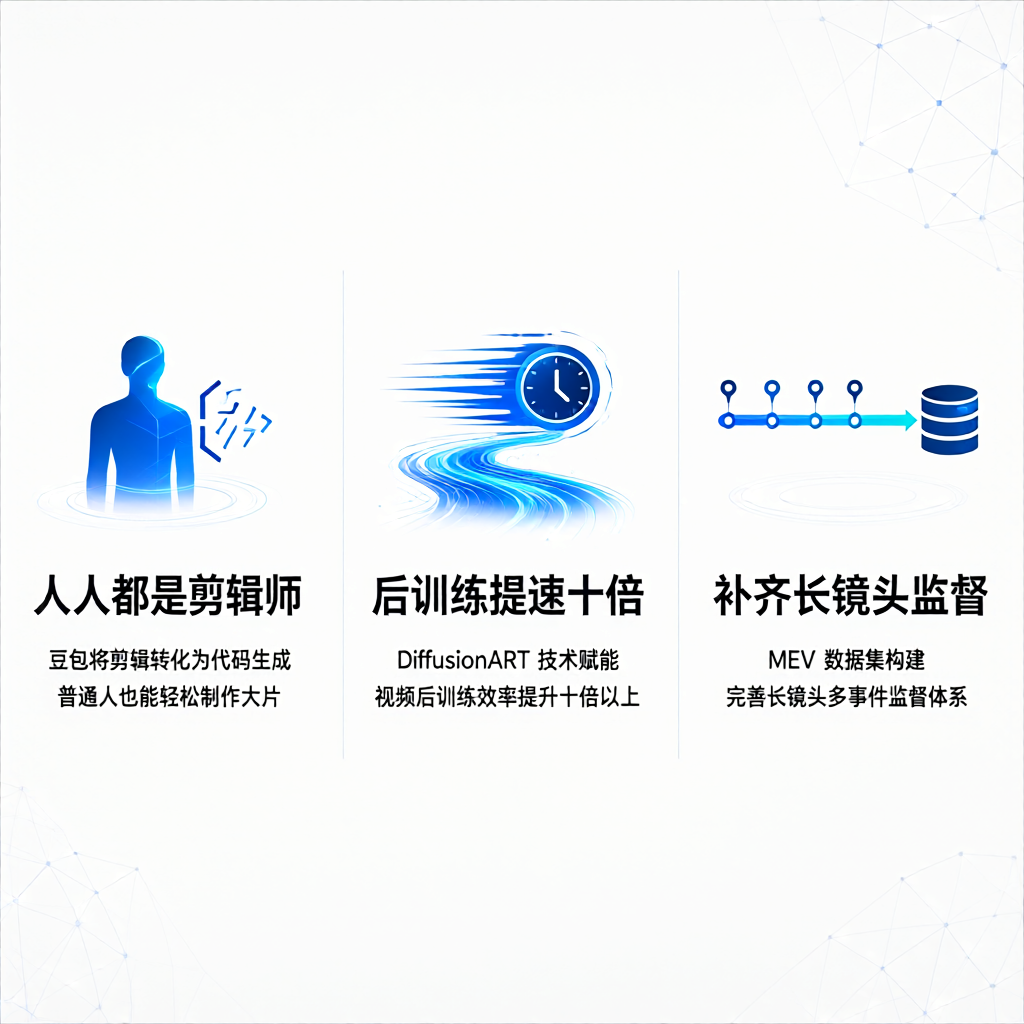
AI视频眼下三条线同时推进:生成更快、训练更稳、数据更长。豆包把"剪辑"换成了"写代码生成"——每一帧都是算出来的,改哪里点哪里,不用整条时间线重渲。手里有照片就能出片,年终骑行回顾、赛道日花絮、女骑合集、车友婚礼集锦都吃得下。
后训练这头,新国立和可灵AI的DiffusionART盯上一个硬问题:用reward微调扩散模型时,模型究竟受了哪些力,这些力产生多大梯度,彼此又是什么关系。把这件事捋清楚之后,Diffusion RL做得更高效、更稳定、可扩展,视频后训练提速十倍以上。效率不是靠砍精度换来的,是靠搞懂梯度怎么走。
数据端的短板更明显。arXiv上的MEV数据集直接点破:现有文生视频数据基本是单事件短视频,配的文字描述还粗,对"长镜头"建模几乎没有监督价值。MEV用多事件视频补位,让模型学着在一个连续镜头里把好几件事讲完,而不是剪成一堆碎镜头。
三件事拼起来其实是一条链:数据决定模型能学多长,算法决定训练多快多稳,工具决定谁能上手。前两端还在实验室里提速,最后一端已经把成片交到普通用户手上。AI视频的门槛,正被从两头一起削平。