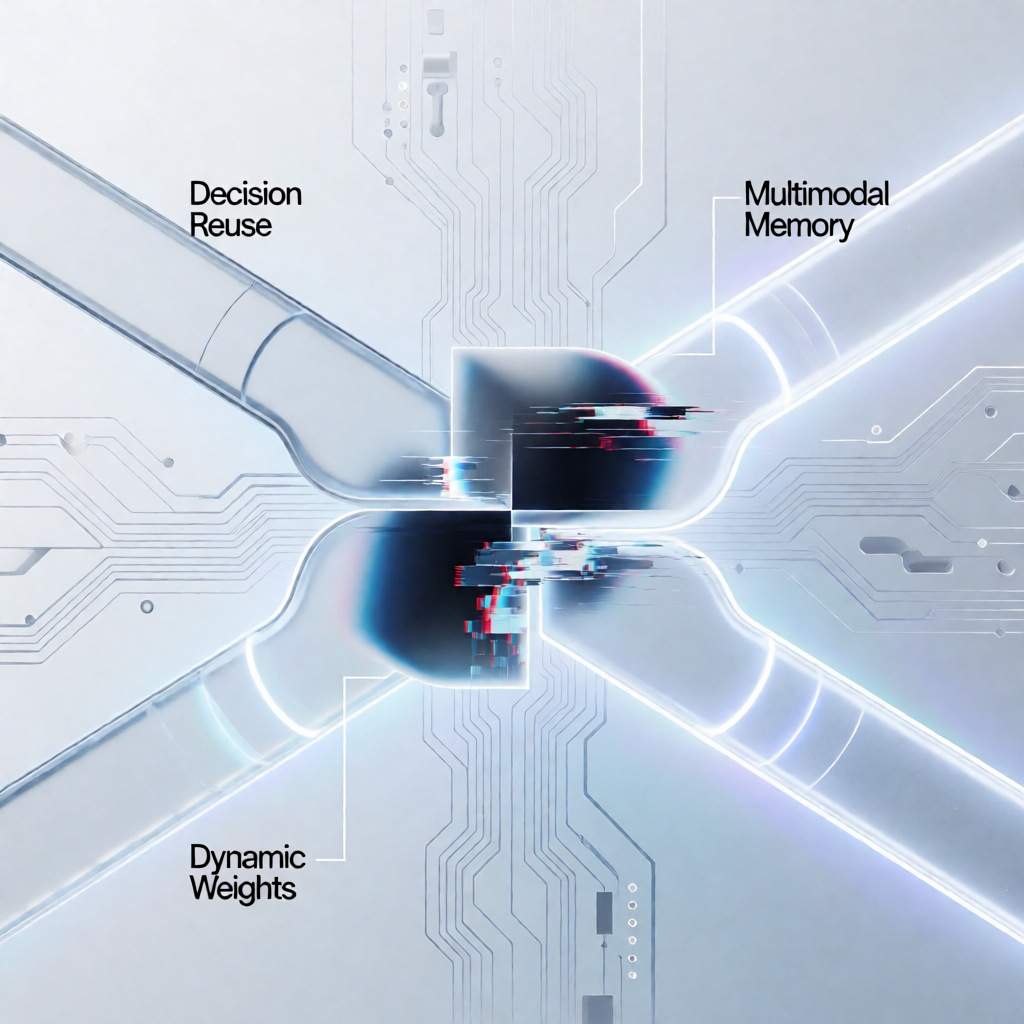
智能体跑长任务,最容易卡在"反复做同一类决定"上。arXiv论文《Bellman Language Models》把"决策"和"生成"拆开看,发现LLM的决策空间接近饱和,真正烧算力的是那些重复出现的决策点。作者借贝尔曼方程处理这类循环决策,智能体不用每次都从头推理一遍,很多调用本来就能复用。
视觉场景更麻烦。《OpenVLHarness》指出,多模态模型在视觉推理上进步很快,但不少任务要的证据,靠"内部想一想"根本拿不到。他们的做法是给智能体配上真实世界的工具调用能力,再加一套多模态记忆。看过的东西存下来,需要时去查、调工具验证,不让模型硬猜。
长程任务的坑在另一边。《WeAct》盯的是另一个问题:智能体要从交错的轨迹里学会多种异构能力,可一更新共享参数,之前学会的本事就可能被冲掉,直接灾难性遗忘。他们的方案是把"动态切换权重"本身当成一种动作,用哪套权重由智能体自己决定,新能力就不会踩坏旧能力。
三篇论文指向同一个判断:智能体的瓶颈挪到了架构上,跟模型大小关系不大。决策能复用就复用,证据该外挂就外挂,能力该分模块就分模块。一个模型包打天下的思路,正被一点点拆开。